
L’ANALISI
Xinference 4: prefill e decode tra vLLM, SGLang, NVIDIA e Apple Silicon
Analisi pratica di Xinference 4.0: cache KV condivisa, prefill/decode eterogeneo, ricarica del motore senza rileggere i pesi e compatibilità Responses API.
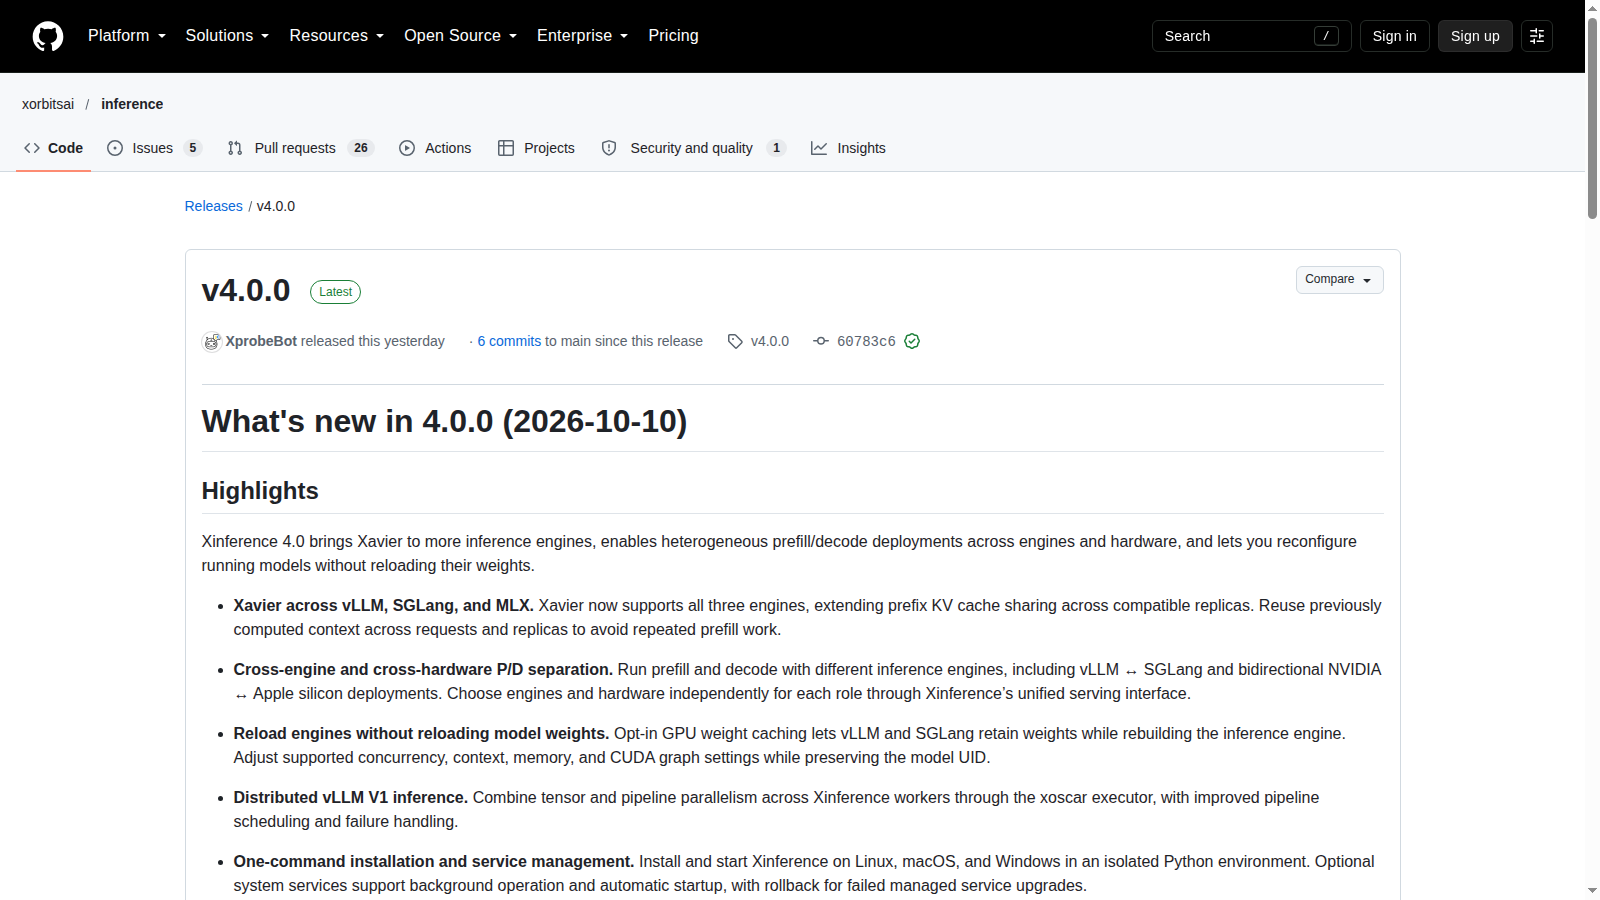
In breve: Xinference 4.0 rende più flessibile un cluster di inferenza locale o ibrido: prefill e decode possono usare motori e hardware differenti, mentre Xavier condivide la cache KV tra repliche compatibili. È un cambiamento operativo concreto, ma va provato con i propri modelli perché latenza, trasferimenti e compatibilità possono annullare il vantaggio.
Che cosa cambia nella versione 4.0
Xavier ora copre vLLM, SGLang e MLX. L’obiettivo è riutilizzare il contesto già calcolato tra richieste e repliche compatibili, riducendo il lavoro di prefill ripetuto.
Prefill e decode non devono più stare sullo stesso stack
La release dichiara separazione bidirezionale tra NVIDIA e Apple Silicon e combinazioni vLLM con SGLang. Questo consente di assegnare le due fasi a risorse diverse, ma introduce trasferimenti e dipendenze di rete da misurare.
Riconfigurare senza ricaricare i pesi
La cache GPU opzionale mantiene i pesi mentre viene ricostruito il motore. Si possono modificare concorrenza, contesto, memoria e impostazioni CUDA Graph preservando l’identificativo del modello.
Compatibilità applicativa e gestione
Il nuovo endpoint stateless /v1/responses supporta streaming e tool call. L’installazione gestita può creare servizi di sistema su Linux, macOS e Windows e prevede rollback per gli aggiornamenti non riusciti.
Condizioni e limitazioni
I vantaggi prestazionali dipendono da rete, compatibilità dei modelli, motore e topologia hardware. Le note di rilascio descrivono le funzioni, ma non sostituiscono benchmark riproducibili sulla propria infrastruttura né una verifica delle nuove superfici di autenticazione e rete.
Checklist pratica
- Fissare la release v4.0.0 e verificare la matrice di compatibilità del modello con vLLM, SGLang o MLX.
- Misurare separatamente time to first token, token al secondo, traffico di rete e hit rate della cache KV.
- Confrontare una topologia omogenea con la separazione prefill/decode prima di cambiare il percorso di produzione.
- Provare /v1/responses con streaming e tool call usando una suite di compatibilità dell’applicazione.
- Limitare porte, credenziali e accesso ai log; verificare il rollback del servizio in un ambiente non critico.