
L’ANALISI
llama.cpp: Kokoro e Qwen3-TTS reference
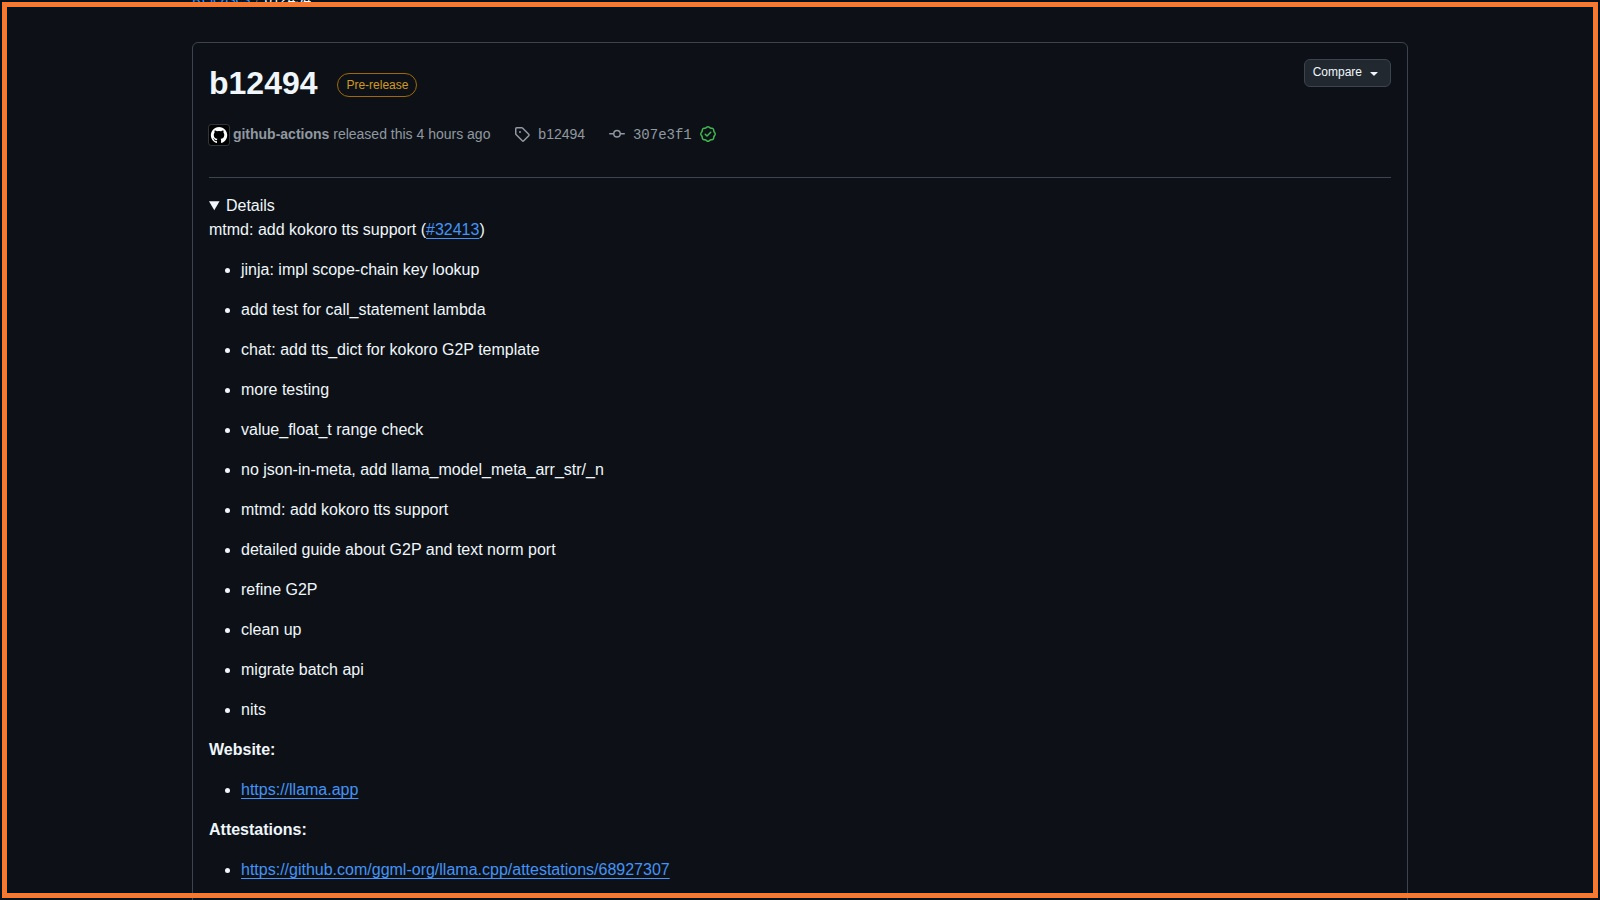
llama.cpp integra Kokoro in b12494 e la modalità reference di Qwen3-TTS in b12491. Sono prerelease del runtime, non nuovi modelli o test audio.
In breve: llama.cpp b12491 aggiunge il supporto alla modalità reference di Qwen3-TTS, che prosegue da un audio di riferimento invece di usarne soltanto l'embedding; b12494 aggiunge Kokoro con pipeline grafema-fonema gestita in template Jinja. Le due prerelease integrano capacità nel runtime mtmd: non annunciano nuovi modelli e non dimostrano prestazioni, qualità in italiano o risultati di clonazione ottenuti da noi. llama.cpp b12494: prerelease con Kokoro TTS.
Analisi documentale delle fonti primarie verificata il 18 novembre 2026. Le checklist sono protocolli proposti: nessun test di account, audio o runtime è stato eseguito.
Che cosa integra b12494 per Kokoro?
La release b12494 richiama la PR 32413, dedicata al supporto Kokoro nel percorso mtmd. La descrizione della PR identifica Kokoro-82M e stabilisce un criterio di implementazione: la trasformazione da grafemi a fonemi, indicata come G2P, deve essere gestita in un template Jinja. La motivazione dichiarata è evitare di caricare il binario compilato di troppo codice specifico dei singoli modelli, che non serve a chi non usa TTS. È una scelta di integrazione e organizzazione del runtime, non l'annuncio di un nuovo addestramento o di nuovi pesi Kokoro. llama.cpp b12494: prerelease con Kokoro TTS · PR 32413: supporto Kokoro e pipeline G2P nei template.
Che cosa cambia in Qwen3-TTS reference?
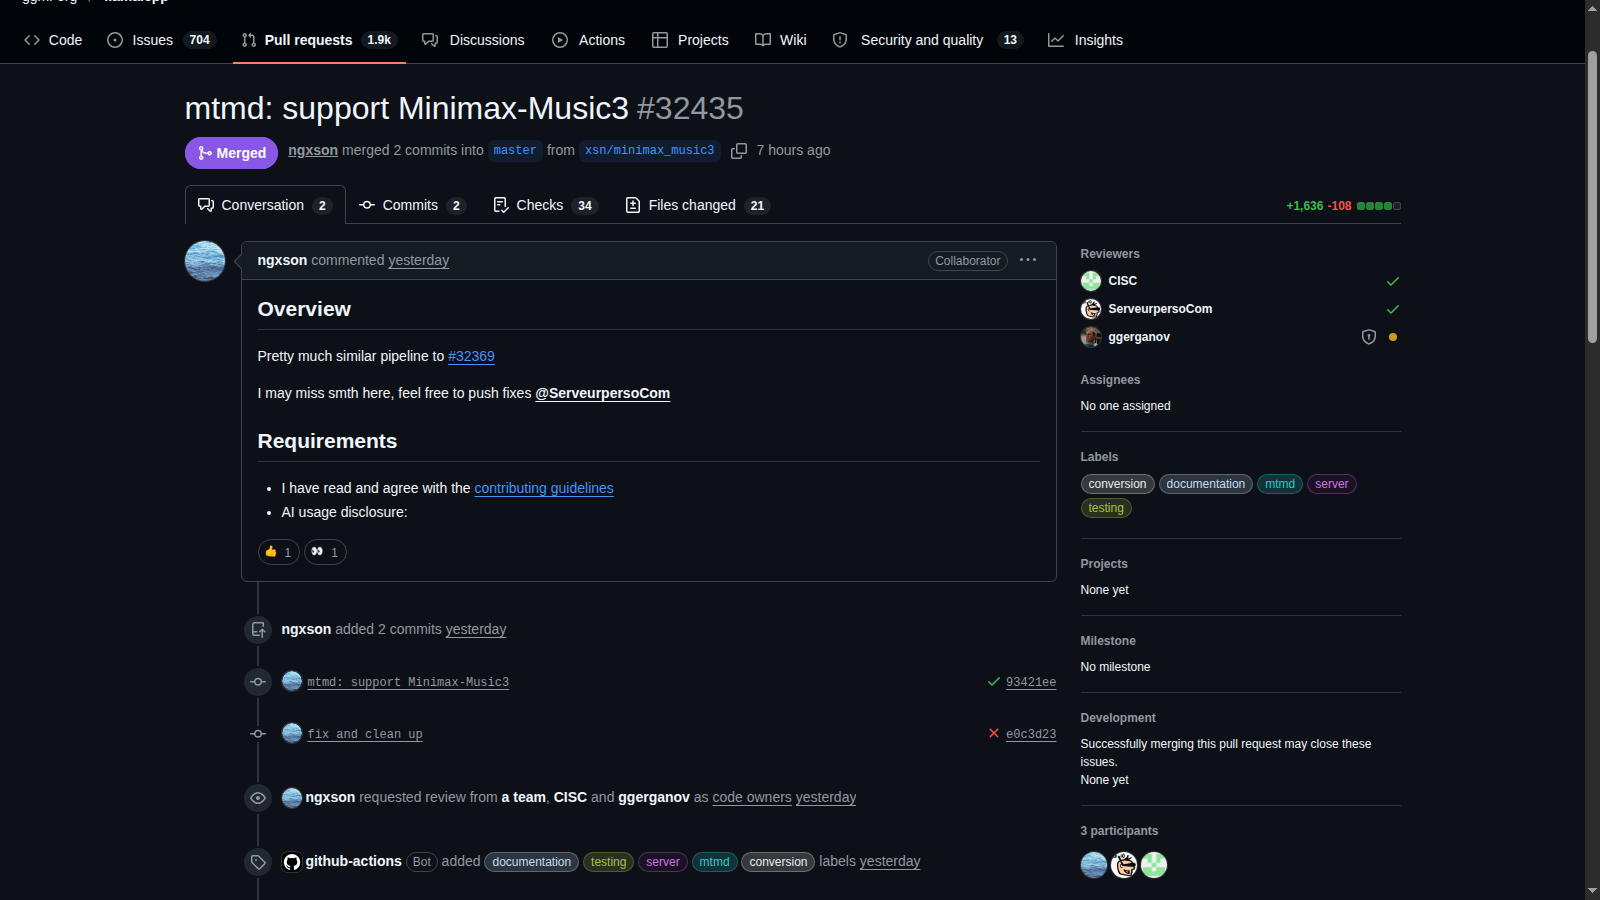
b12491 include la PR 32438 per la modalità ICL/reference di Qwen3-TTS. Il testo spiega la differenza in modo circoscritto: il percorso continua da un audio di riferimento invece di usarne soltanto l'embedding. Non va quindi raccontato come il primo supporto assoluto a Qwen3-TTS o come la nascita del modello. Il contributore descrive una propria esperienza favorevole rispetto a xvector, ma quella valutazione personale non è un benchmark indipendente né una misura trasferibile ai nostri casi. Qui non abbiamo riprodotto la sintesi, ascoltato campioni o confrontato risultati a parità di input. llama.cpp b12491: prerelease con Qwen3-TTS ICL/reference · PR 32438: Qwen3-TTS continua da un audio di riferimento.
Sono release stabili o prerelease?
Le risposte API appena acquisite riportano draft=false e prerelease=true per entrambe le versioni. Per b12491 la pubblicazione è il 18 novembre 2026 alle 01:35:06 UTC, quindi alle 02:35:06 italiane; per b12494 è alle 02:37:28 UTC, quindi alle 03:37:28 italiane. I merge delle PR sono precedenti: Qwen reference il 17 novembre alle 17:59:12 UTC e Kokoro alle 21:25:45 UTC. Questa distinzione evita due equivoci: chiamare stabile un pacchetto marcato prerelease e confondere il momento del merge con quello in cui viene pubblicato l'artefatto della release. llama.cpp b12494: prerelease con Kokoro TTS · PR 32413: supporto Kokoro e pipeline G2P nei template · llama.cpp b12491: prerelease con Qwen3-TTS ICL/reference · PR 32438: Qwen3-TTS continua da un audio di riferimento.
Si può già promettere una buona voce italiana?
Non sulla base di questa verifica. I documenti letti confermano le integrazioni nel codice e le versioni che le includono, ma qui non abbiamo compilato il progetto né prodotto un file audio. Non sono stati misurati pronuncia italiana, latenza, tempo al primo campione, memoria o continuità fra segmenti. Restano inoltre da verificare pesi canonici, licenze e configurazione effettivamente usata prima di suggerire un impiego concreto. Separare questi passaggi permette di seguire il runtime senza trasformare una nota di rilascio in una recensione di qualità vocale o in una guida di installazione già collaudata. llama.cpp b12494: prerelease con Kokoro TTS · PR 32413: supporto Kokoro e pipeline G2P nei template · llama.cpp b12491: prerelease con Qwen3-TTS ICL/reference · PR 32438: Qwen3-TTS continua da un audio di riferimento.
Quali cautele servono con un audio di riferimento?
Per un'eventuale prova della modalità reference proponiamo soltanto una voce propria o un campione per il quale esista consenso esplicito all'uso previsto. Questa è una cautela editoriale, non una funzione di controllo del consenso dimostrata dal runtime. Il fatto che un file sia reperibile online non viene trattato come autorizzazione a usarlo per riprodurre una voce. La prova andrebbe inoltre presentata come sintetica, senza attribuire al parlante frasi che non ha pronunciato realmente. Non abbiamo raccolto campioni di terzi né generato una voce per questa analisi documentale. PR 32438: Qwen3-TTS continua da un audio di riferimento.
Come confrontare i due aggiornamenti senza confonderli?
Il primo confronto utile è fra le funzioni, non fra presunte classifiche: Kokoro aggiunge il proprio percorso di sintesi e la gestione G2P tramite template, mentre Qwen3-TTS amplia una modalità di condizionamento su audio. Per una futura prova andrebbero conservati revisione, file dei pesi, template, testo, riferimento autorizzato e parametri, separando avvio e generazione. Le due notizie restano riconoscibili anche in questo articolo unico, con i rispettivi tag e PR, perché riguardano cambiamenti distinti. Un esito favorevole su un modello non dimostrerebbe automaticamente il funzionamento, la qualità o i requisiti dell'altro. llama.cpp b12494: prerelease con Kokoro TTS · PR 32413: supporto Kokoro e pipeline G2P nei template · llama.cpp b12491: prerelease con Qwen3-TTS ICL/reference · PR 32438: Qwen3-TTS continua da un audio di riferimento.
Condizioni e limitazioni
b12491 e b12494 sono prerelease, non release stabili; non abbiamo compilato il runtime né generato voce, verificato licenze dei pesi o misurato l'italiano, e qualsiasi futura prova con audio di riferimento richiede una voce propria o consenso esplicito. llama.cpp b12494: prerelease con Kokoro TTS.
Checklist pratica
- Conservare tag e PR separati: b12494/32413 per Kokoro, b12491/32438 per Qwen3-TTS reference.
- Trattare entrambi i pacchetti come prerelease e mantenere una configurazione precedente recuperabile.
- Verificare provenienza e licenza dei pesi e dei template prima di una futura installazione.
- Usare per il riferimento soltanto la propria voce o audio con consenso esplicito all'impiego previsto.
- Misurare l'italiano su testi identici, conservando audio, parametri e tempi senza riutilizzare benchmark altrui.
- Dichiarare sempre la natura sintetica di eventuali campioni e non presentare test mai eseguiti.