
L’ANALISI
llama.cpp b11958: chiamare i tool nella conversazione realtime
llama.cpp b11958 aggiunge tool calling a /v1/realtime: commit del 28 ottobre, ruolo del client, modelli indicati e limiti della demo set_volume.
In breve: Per costruire un assistente vocale locale, il cambiamento utile è poter completare nello stesso flusso realtime il passaggio da una richiesta a una funzione e poi alla risposta. Il codice di esempio mantiene però l’esecuzione nel client. Autorizzazioni, validazione degli argomenti e controllo degli effetti restano responsabilità dell’applicazione: la presenza del tool nel protocollo non le sostituisce.
Che cosa è cambiato il 28 ottobre
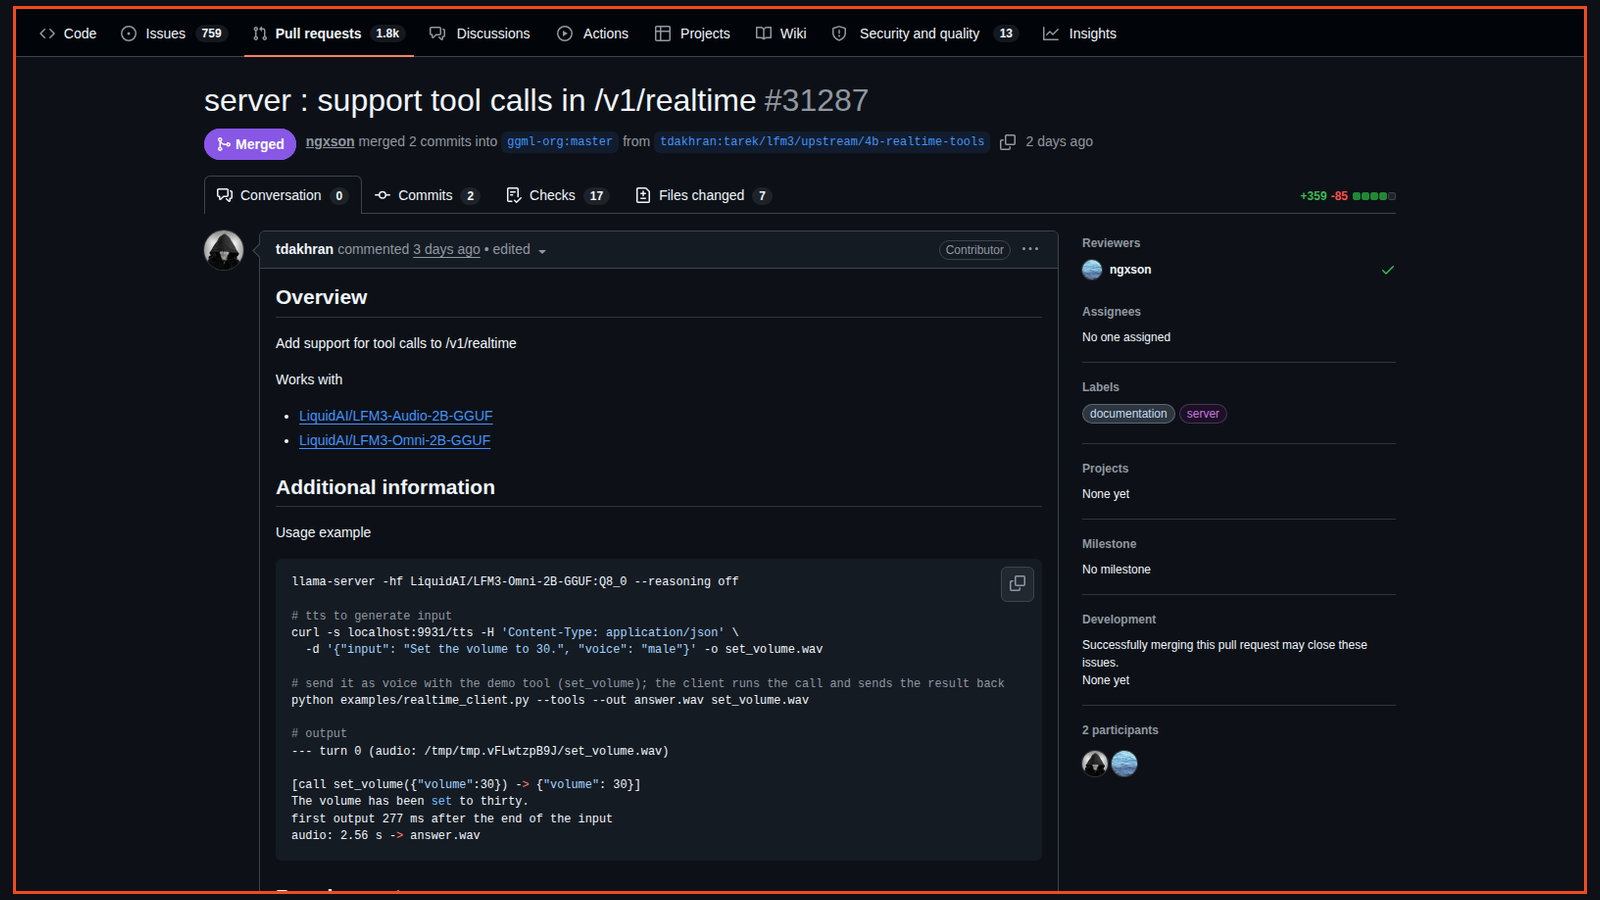
La PR 31287 è stata integrata il 28 ottobre 2026 alle 11:17:13 UTC nel commit d1eb0de. Il riferimento Git del tag b11958 restituisce lo stesso commit. È un delta verificabile rispetto alle coperture precedenti di llama.cpp: qui il tema sono le chiamate ai tool di /v1/realtime, non il supporto TTS già raccontato. Il percorso web delle release è consultabile, ma l’endpoint REST della release per questo tag risponde 404. Per questo il testo parla di tag e codice integrato, non di versione stabile.
Il client chiude il ciclo della funzione
Nella documentazione fissata al commit, i tool entrano nella sessione; il server produce elementi function_call e il client restituisce function_call_output con il relativo call_id. Una richiesta successiva genera la continuazione della risposta. Implicazione pratica proposta: conservare il legame tra richiesta, funzione eseguita e risultato, invece di considerare la frase pronunciata dall’assistente come prova dell’esecuzione. Nel registro applicativo dovrebbero comparire anche esito e motivo di un eventuale rifiuto.
Due modelli indicati, non compatibilità universale
La descrizione ufficiale della PR indica LiquidAI/LFM3-Audio-2B-GGUF e LiquidAI/LFM3-Omni-2B-GGUF. Il README della revisione richiede per LFM3-Omni l’opzione --reasoning off. Sono indicazioni del progetto per questa integrazione, non un test Radar su ogni modello o quantizzazione. Per la valutazione proposta, fissare checkpoint, quantizzazione e revisione del server: cambiare contemporaneamente questi tre elementi renderebbe poco leggibile un eventuale confronto con la configurazione precedente.
La demo set_volume non comanda una cassa audio
Il client di esempio contiene un tool set_volume; la sua funzione restituisce il valore ricevuto in un oggetto JSON. Nel corpo verificato non c’è una chiamata al mixer o a un dispositivo. Questo distingue una dimostrazione del passaggio di messaggi da un’integrazione hardware. Non sono stati misurati latenza, correttezza vocale o comportamento su richieste italiane. Un output mostrato nella PR resta la dimostrazione del contributore, non un risultato riprodotto da questa redazione.
Mettere i permessi prima dell’esecuzione
Analisi operativa proposta: iniziare con una funzione di sola lettura o una risposta fittizia e consentire soltanto nomi e argomenti previsti. Stabilire che cosa fare in caso di chiamata ripetuta, timeout o risposta non valida del tool, prima di collegare azioni reali. Se una richiesta può cambiare dati o comandare un dispositivo, aggiungere una conferma esplicita e un registro dell’esito. Sono requisiti consigliati per l’applicazione, non protezioni che questo cambiamento dimostri di fornire automaticamente.
Una verifica proposta, senza inventare un benchmark
Procedura proposta, non eseguita da Radar: preparare un server isolato con la revisione scelta e usare il client della medesima revisione. L’esempio ufficiale avvia llama-server -hf LiquidAI/LFM3-Omni-2B-GGUF:Q8_0 --reasoning off; il client dispone dell’opzione --tools per la funzione dimostrativa. Prima verificare l’andata e ritorno del risultato senza effetti esterni; poi aggiungere audio autorizzato e richieste ambigue o non eseguibili. Registrare chiamata attesa, chiamata prodotta, risultato e risposta finale, tenendo separata ogni misura di tempo.
Condizioni e limitazioni
È un tag e un cambiamento integrato nel repository, non una release stabile confermata via REST. Radar non ha compilato llama.cpp, scaricato modelli o eseguito conversazioni vocali. Il client dimostrativo set_volume restituisce un oggetto JSON: non modifica il volume del sistema e non prova il controllo di un dispositivo reale.
Checklist pratica
- Registrare il commit d1eb0debaddc9f9246ee884653ee3a7764f60b77 e non presentare b11958 come release stabile.
- Usare server e client della stessa revisione e fissare il modello scelto.
- Per LFM3-Omni, controllare l’opzione --reasoning off indicata dalla documentazione.
- Verificare la corrispondenza del call_id tra function_call e function_call_output.
- Iniziare con il tool dimostrativo o una funzione senza effetti esterni.
- Gestire argomenti invalidi, timeout e ripetizioni prima di abilitare azioni reali.
- Non trasformare la demo del contributore in una promessa di latenza, qualità italiana o controllo hardware.