
L’ANALISI
Nemotron 3.5 Bolt E4B 4GB: agenti locali con tool calling
Nemotron 3.5 Bolt E4B 4GB: GGUF locale, 64K, tool calling, modalità conversazionale, licenza e limiti per assistenti vocali o embedded.
In breve: Nemotron Bolt rende scaricabile un modello Q4_K_M da 6,18 GB orientato a conversazioni rapide, strumenti e interfacce locali. Può controllare ragionamento e stile conversazionale e servire un endpoint OpenAI-compatible con llama.cpp. Non è però un modello audio: per un assistente vocale servono ancora riconoscimento e sintesi separati.
Che cosa viene distribuito
Il repository contiene un singolo GGUF Q4_K_M derivato dal checkpoint BF16, con 8B parametri totali e 4B effettivi. La model card dichiara input e output testuali e contesto fino a 64K.
Modalità conversazionale e ragionamento
Il template consente di attivare o disattivare il ragionamento, impostare un budget e usare una modalità conversazionale più concisa. Sono controlli utili per interfacce vocali, ma vanno testati perché budget stretti possono troncare il ragionamento.
Tool calling e agenti locali
NVIDIA documenta tool calling, output strutturati e una procedura con server compatibile OpenAI. La qualità degli strumenti dipende da schema, sequenza dei messaggi, gestione degli errori e conferma prima di azioni con effetti reali.
Il confine della voce
Il modello genera testo. L’etichetta voice assistant descrive il caso d’uso complessivo, non una pipeline speech-to-speech inclusa: microfono, ASR, turn detection e TTS restano moduli distinti da integrare e misurare.
Benchmark, licenza e hardware
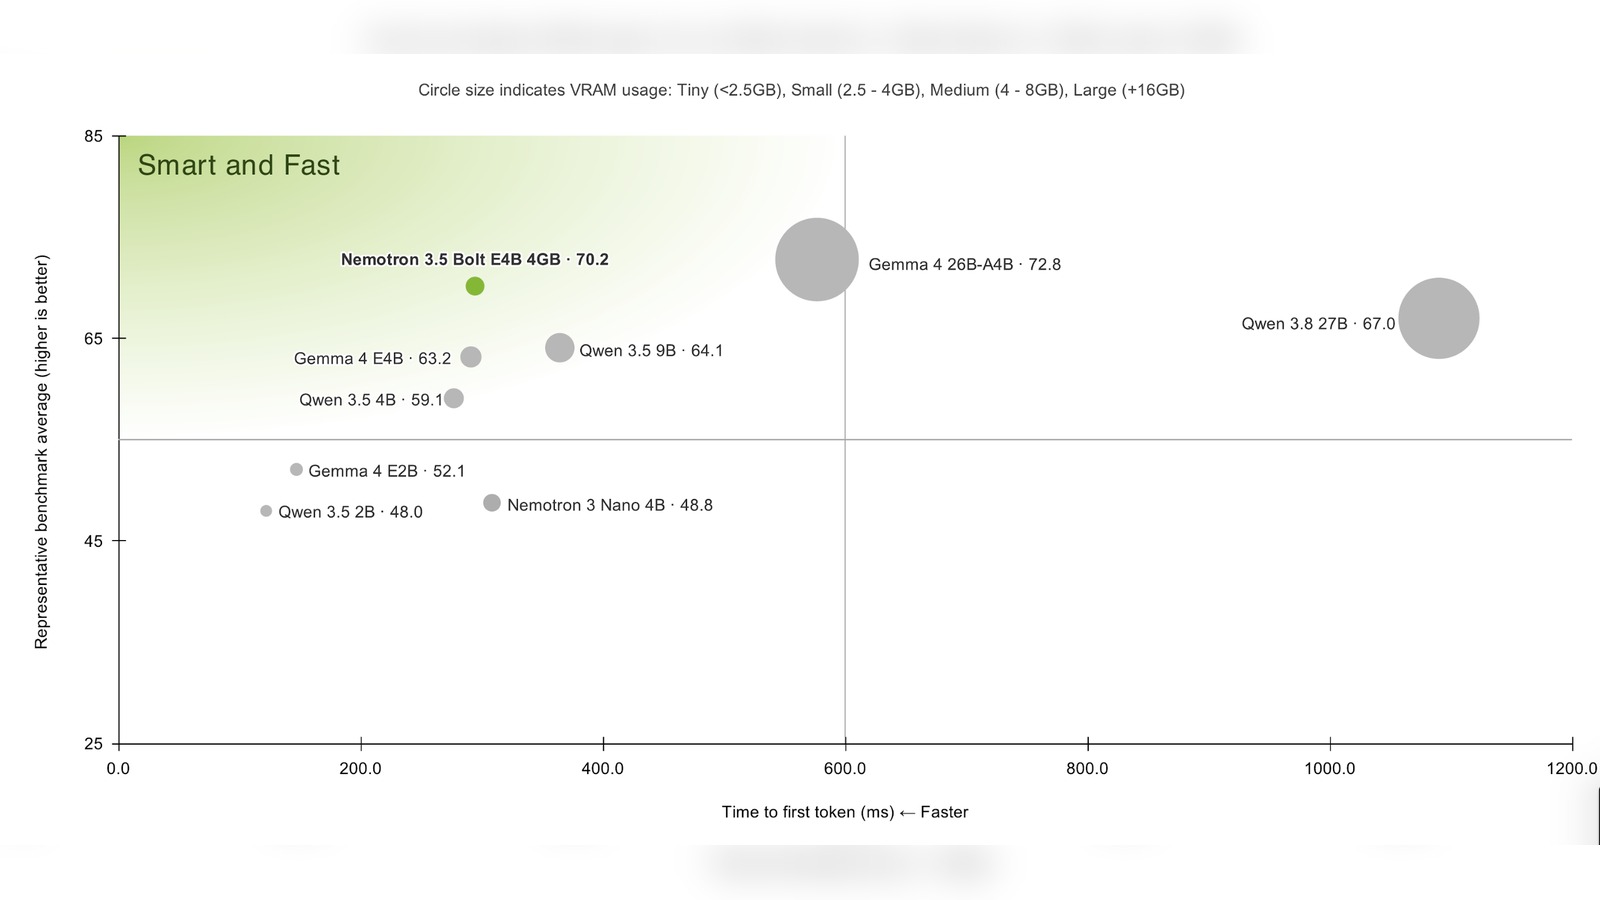
I risultati comparativi sono dichiarazioni NVIDIA ottenute con NeMo Gym. Il checkpoint usa OpenMDW 1.1 ed è destinato anche a uso commerciale; prima del deploy servono verifica della licenza, memoria reale, latenza, regressioni multilingue e sicurezza degli strumenti.
Condizioni e limitazioni
I benchmark sono misurati da NVIDIA con il proprio harness e non sostituiscono test indipendenti. La ricetta llama.cpp è indicata come ancora in completamento nonostante i comandi presenti; il modello usa OpenMDW 1.1, non Apache 2.0, e il consumo operativo supera la sola dimensione del GGUF.
Checklist pratica
- Leggere OpenMDW 1.1 e registrare checkpoint, revisione e hash del GGUF.
- Avviare llama.cpp in rete locale con contesto iniziale più corto di 64K.
- Testare ragionamento on, off e budget controllato sugli stessi prompt.
- Verificare tool calling con schemi validi, errori e richieste ambigue.
- Misurare RAM, VRAM, tempo al primo token e token al secondo.
- Per la voce, misurare separatamente ASR, modello, TTS e latenza end-to-end.