
IL PUNTO SULL’AI
24 ottobre 2026
Sandbox Runtime corregge bypass Windows per gli agenti; MedGemma, Granite, Soprano, Nemotron e i GGUF DeepSeek restano il quadro operativo su modelli e inferenza locale.
In questa edizione 6 notizie
Google Research descrive il passaggio dalla ricerca alla distribuzione: un dispositivo di Nexus AI basato su algoritmi per radiografie toraciche è impiegato in sei Paesi, mentre l’Indonesia sta adattando MedGemma e MedSigLIP su dati locali per un programma che punta a 50 milioni di screening l’anno. I modelli aperti possono funzionare su infrastruttura locale, ma non sono da soli un dispositivo medico autorizzato.
Limiti da conoscere
Limite: La certificazione CE MDR di classe IIb citata riguarda il dispositivo clinico di Nexus AI, non MedGemma in generale. Numeri di diffusione, prestazioni e impatto provengono da Google e partner; ogni nuovo contesto richiede validazione clinica locale, governance dei dati, conferma diagnostica e autorizzazioni applicabili.
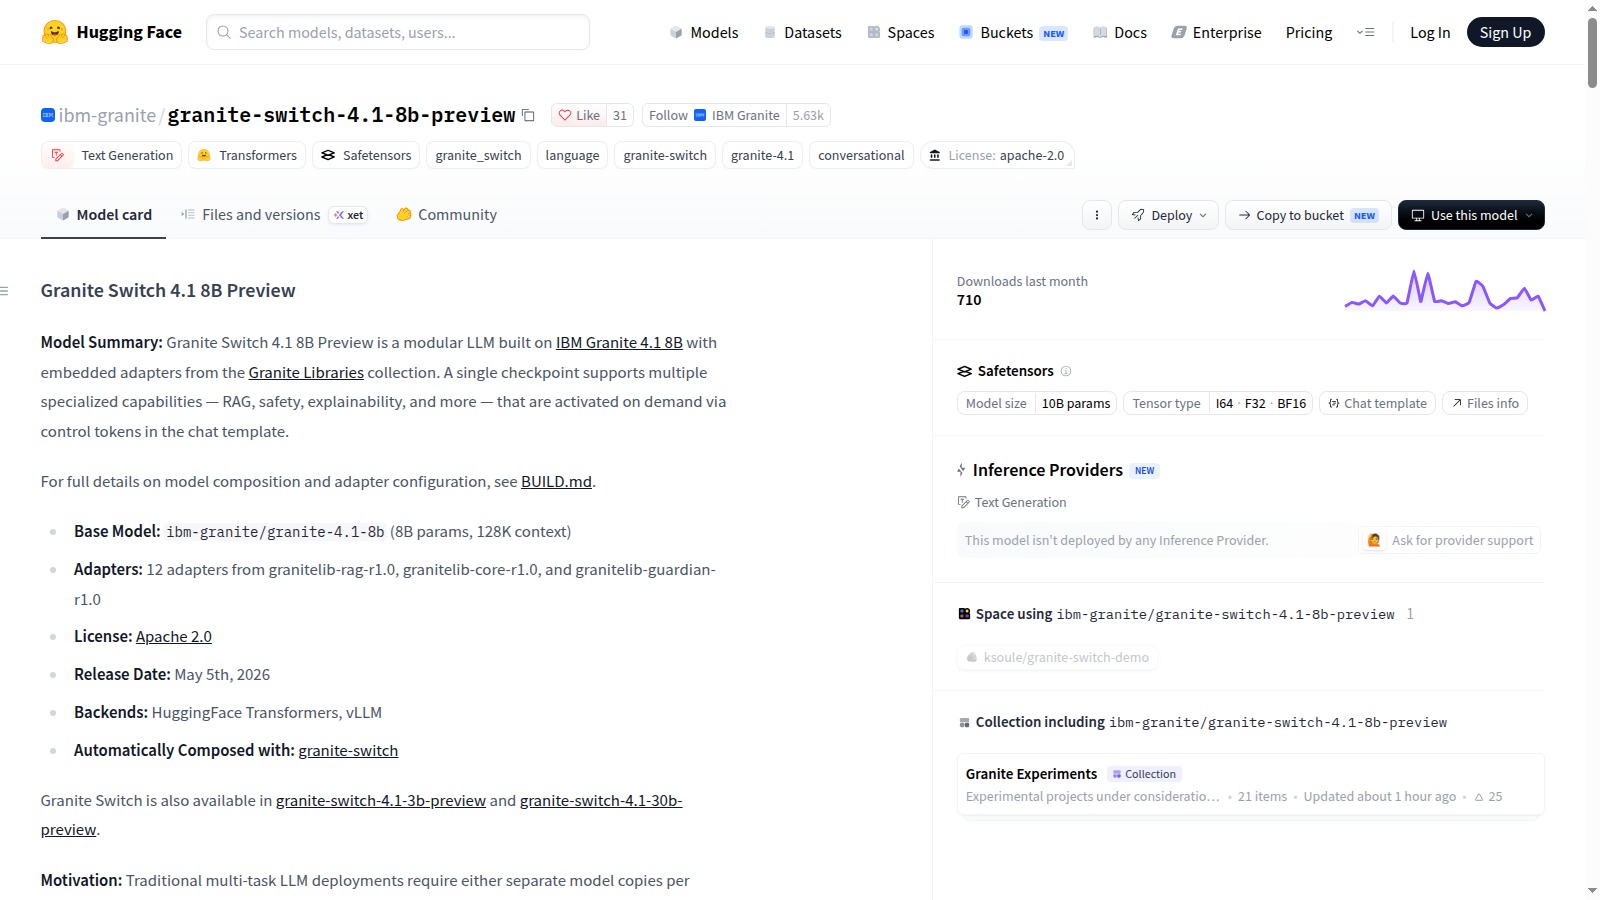
IBM ha pubblicato repository GGUF ufficiali per Granite Switch 4.1 8B e 30B, con BF16 e quantizzazioni da Q2_K a Q8_0. La variante Q4_K_M pesa circa 6,41 GB per l’8B e 21,04 GB per il 30B: il delta elimina la conversione manuale e rende più ripetibile il download per llama.cpp.
Limiti da conoscere
Limite: I file ufficiali semplificano il packaging, non dimostrano qualità, velocità o calibrazione sul proprio hardware. Il 30B resta molto più impegnativo; quantizzazione, contesto e adapter attivi possono cambiare memoria e risultati. I repository sono Apache 2.0, ma va verificata anche la model card del checkpoint base.
llama.cpp b11850 integra Soprano 80M e 1.1 80M come pipeline di generazione audio: converte il backbone Qwen3 e il decoder Vocos, carica il decoder come mmproj e produce il file vocale con il tool TTS. Il modello è Apache 2.0 e compatto, ma in llama.cpp l’audio viene emesso in un solo blocco dopo il completamento, non in streaming progressivo.
Limiti da conoscere
Limite: Il supporto è appena entrato nella build continua e non è una release stabile numerata. Soprano è solo in inglese, non offre voice cloning e può pronunciare male termini rari, numeri e simboli. Le velocità dichiarate nella model card sono del progetto e non sono state riprodotte da Radar.
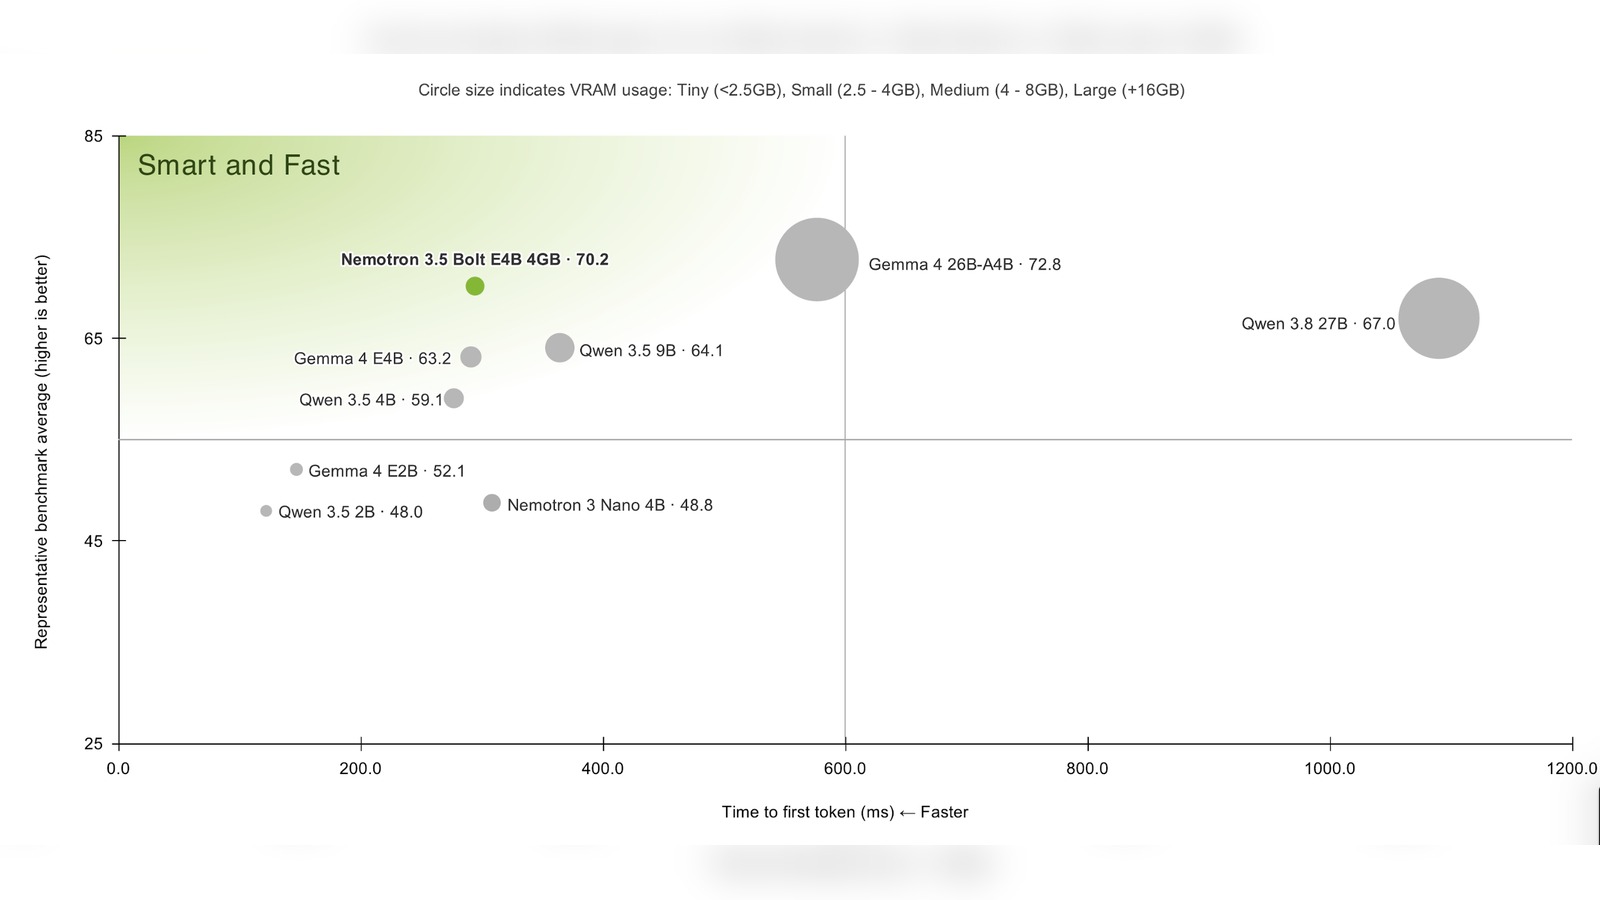
NVIDIA pubblica Nemotron 3.5 Bolt E4B in Q4_K_M: 8 miliardi di parametri totali, 4 miliardi effettivi, file GGUF da 6,18 GB e contesto fino a 64K. Il modello offre modalità conversazionale, ragionamento regolabile e tool calling per assistenti locali; è text-to-text, quindi la voce richiede componenti ASR e TTS separati.
Limiti da conoscere
Limite: I benchmark sono misurati da NVIDIA con il proprio harness e non sostituiscono test indipendenti. La ricetta llama.cpp è indicata come ancora in completamento nonostante i comandi presenti; il modello usa OpenMDW 1.1, non Apache 2.0, e il consumo operativo supera la sola dimensione del GGUF.
ISTA-DASLab pubblica tre quantizzazioni GGUF non uniformi di DeepSeek V4.1 Flash 1017: IQ1_M da 231,32 GB, IQ2_XXS da 248,84 GB e IQ2_XS da 265,83 GB, includendo il file Engram condiviso da 110,60 GB. Strata dichiara l’esecuzione su una GPU NVIDIA con 12 GB di VRAM usando memoria di sistema e SSD, ma llama.cpp non supporta ancora questo formato DeepSeek V4.1.
Limiti da conoscere
Limite: 12 GB indica la VRAM della GPU, non la memoria totale richiesta: il backbone resta in RAM di sistema e le tabelle Engram vengono mappate da SSD. I benchmark sono del produttore, IQ2_XS non ha ancora risultati pubblicati e la model card contiene sezioni operative ancora marcate TBD. Non è un modello pratico per un normale PC con 12 GB di memoria complessiva.
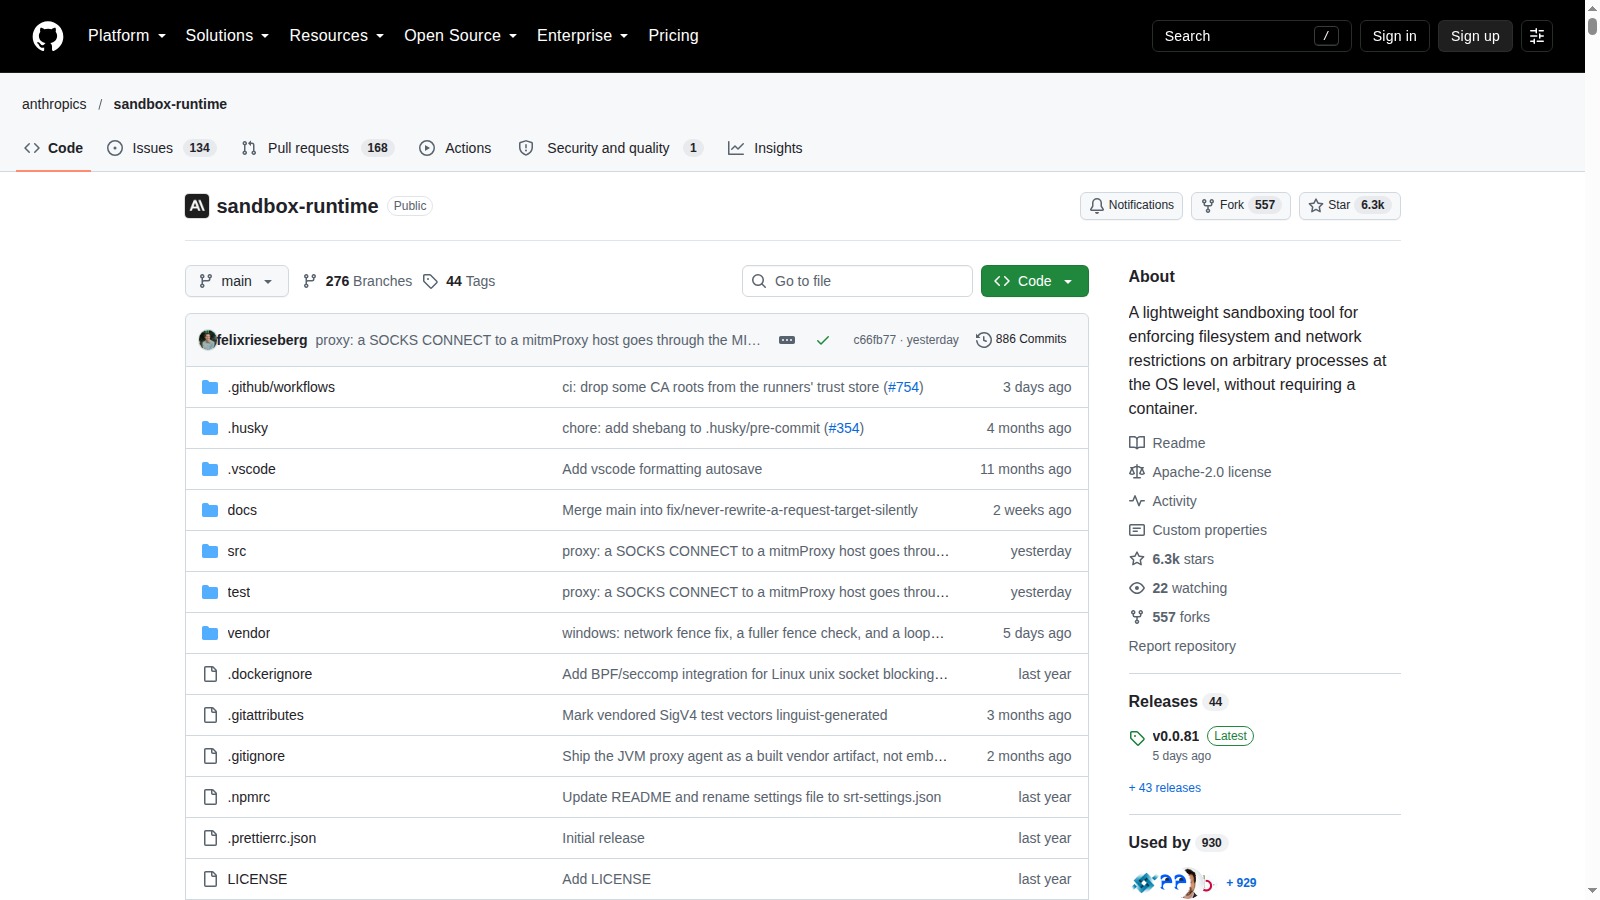
La release v0.0.81 di Anthropic Sandbox Runtime rafforza Windows con un token a scrittura limitata e corregge due vie di uscita: processi AppContainer non intercettati dal filtro di rete e impersonazione tramite la pipe stdin. Chi aggiorna deve rieseguire l’installazione elevata, perché cambia anche la configurazione dei filtri WFP.
Limiti da conoscere
Limite: Tutte le modifiche della v0.0.81 riguardano Windows. Il supporto Windows resta alpha e la documentazione elenca limiti aperti: traffico mediato da servizi di sistema, SMB e WSL non è coperto dal filtro; token anonimi o derivati possono evitare il blocco di rete. Non è un confine adatto a codice ostile senza ulteriori livelli di isolamento.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.