
L’ANALISI
Ollama 0.40 e MLX su Apple Silicon: cosa cambia prima della release stabile
Ollama 0.40 sceglie MLX in automatico per alcuni modelli su Apple Silicon. Cosa cambia, quali modelli sono indicati e come provarlo senza confondere una pre-release con la stabile.
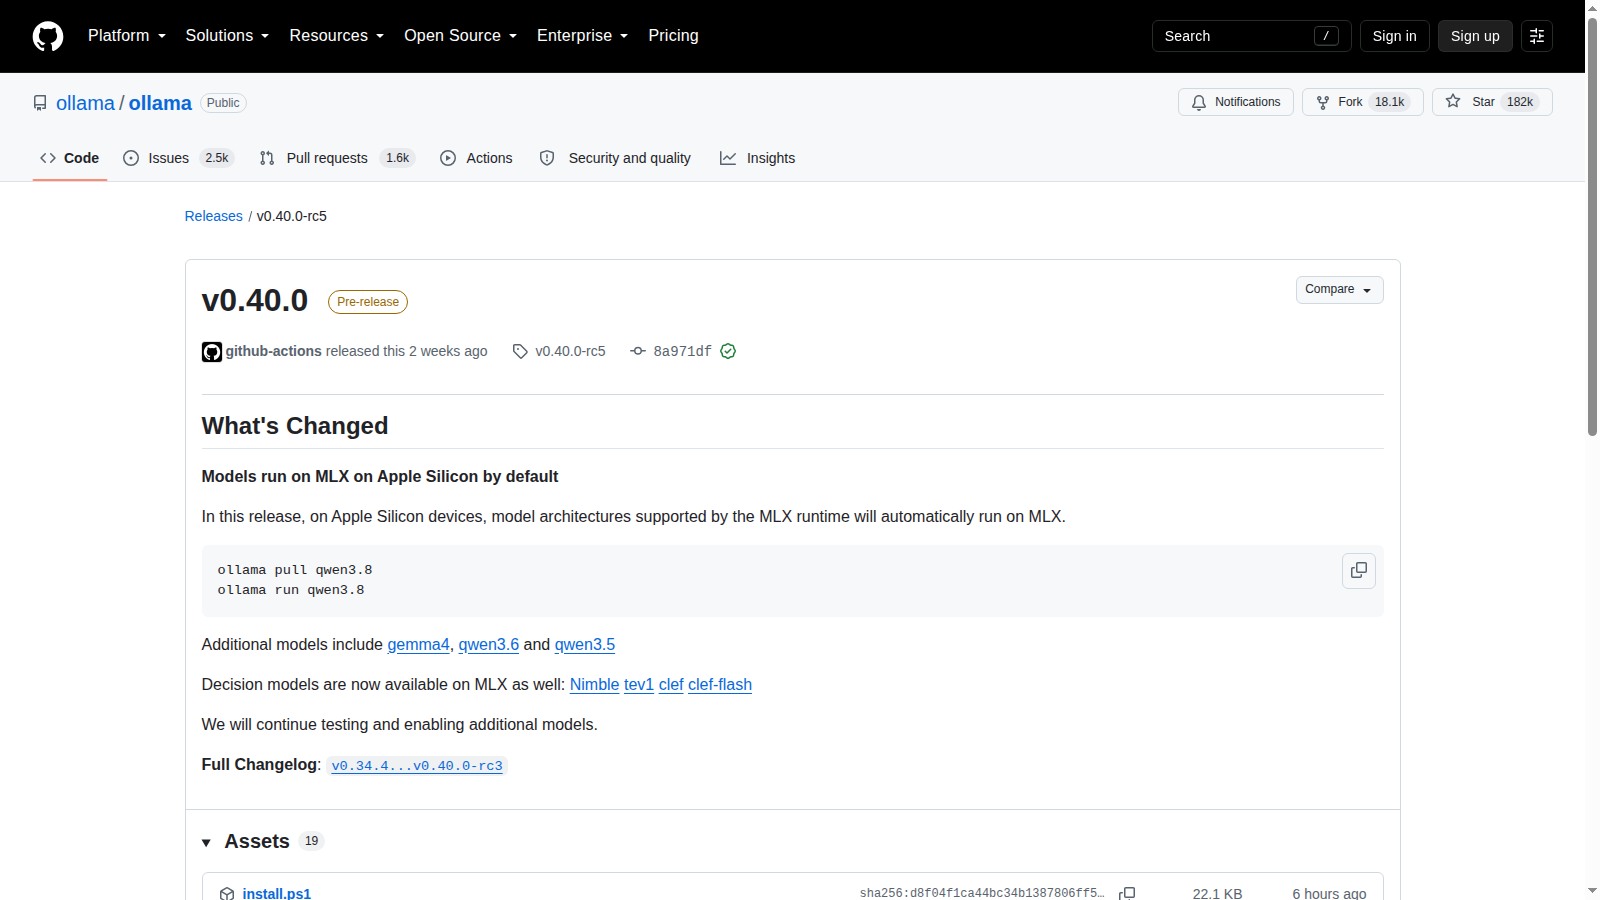
In breve: Ollama 0.40 cambia il percorso predefinito su Apple Silicon: quando l’architettura è supportata, il modello viene eseguito con MLX senza selezione manuale del runtime. È una pre-release, quindi il passaggio va provato e misurato prima di usarlo in produzione.
Che cosa cambia
Su Apple Silicon, Ollama seleziona automaticamente MLX per le architetture che il runtime supporta. L’effetto pratico è un percorso di esecuzione diverso senza cambiare i comandi pull e run.
Quali modelli sono indicati
La release cita Qwen 3.8 come esempio e aggiunge Gemma 4, Qwen 3.6 e Qwen 3.5. Sono elencati anche i decision model Nimble, tev1, clef e clef-flash. Il team dice che abiliterà altri modelli dopo ulteriori test.
Che cosa non dimostra la release
Non sono pubblicati benchmark di token al secondo, latenza, consumo di memoria o confronti con il runtime precedente. Il nuovo default non implica quindi un miglioramento universale né compatibilità automatica con ogni modello presente nella libreria.
Stato del rilascio e rollback
La pagina è marcata pre-release. Prima di aggiornare un ambiente usato per lavoro conviene salvare versione, modello e parametri correnti, testare su una macchina separata e mantenere disponibile la versione stabile precedente.
Condizioni e limitazioni
È ancora una pre-release e il supporto è selettivo: non tutti i modelli passano a MLX. La pagina non pubblica benchmark comparativi, quindi prestazioni, memoria e compatibilità vanno misurate sul proprio Mac prima di adottarla.
Checklist di prova
- Annotare modello, quantizzazione e versione stabile usata come baseline.
- Installare la pre-release su un Mac di prova, non sulla macchina di produzione.
- Eseguire lo stesso prompt e lo stesso contesto su runtime precedente e MLX.
- Misurare tempo al primo token, token al secondo, RAM e stabilità.
- Controllare tool calling, output strutturato e contesti lunghi sui flussi reali.
- Verificare nei log quale runtime è stato selezionato.
- Conservare il comando di rollback e i risultati prima di estendere l’aggiornamento.