
L’ANALISI
llama.cpp b11382: cosa cambia con fill e set_rows FP16 su WebGPU
Analisi della prerelease llama.cpp b11382 e del supporto FP16 per fill e set_rows nel backend WebGPU, con limiti e checklist di verifica.
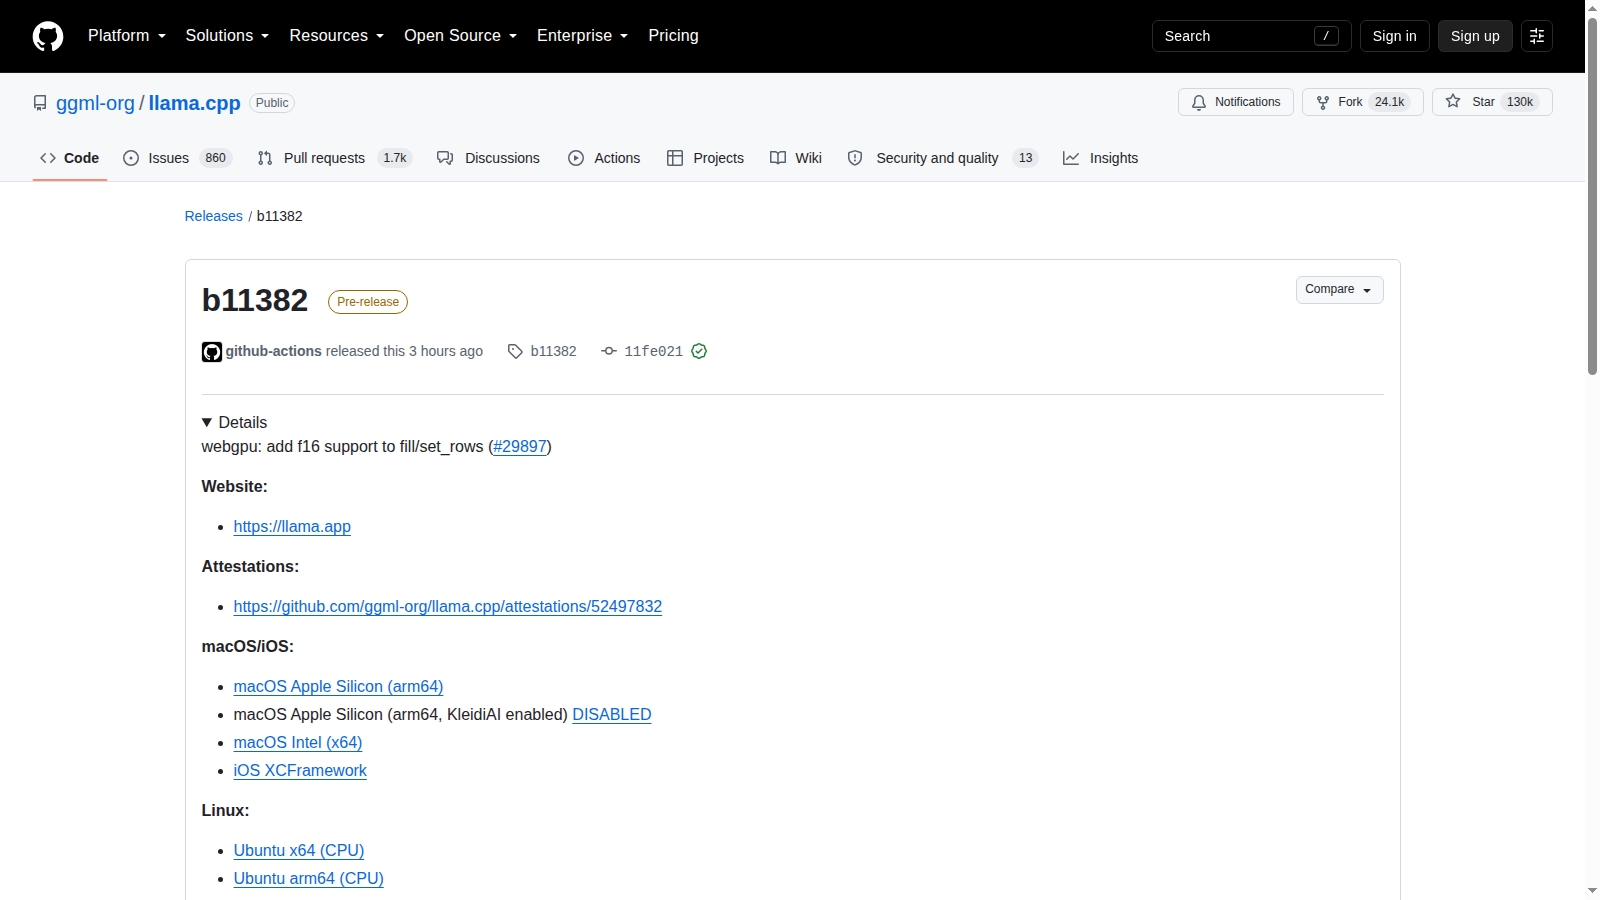
In breve: La b11382 completa due operazioni del backend WebGPU per tensori FP16: fill inizializza valori e set_rows aggiorna righe selezionate senza obbligare il percorso a usare solo FP32. È un miglioramento di compatibilità e trasferimento dati, non una prova di accelerazione complessiva dell’inferenza.
Il delta verificato
La build b11382 è stata pubblicata il 4 ottobre come prerelease con binari per macOS, Linux, Windows, Android e iOS. Il commit associato modifica il backend WebGPU e abilita il tipo f16 in due operazioni che prima non coprivano questo formato.
Che cosa fanno fill e set_rows
fill scrive un valore in un tensore o in una sua regione. set_rows sostituisce righe selezionate usando indici. Sono primitive di supporto: non generano token da sole, ma devono gestire correttamente tipo, stride, offset e dimensioni quando altri grafi le richiamano.
Perché FP16 conta su WebGPU
FP16 dimezza la dimensione di ogni elemento rispetto a FP32 e può evitare conversioni o buffer temporanei quando il grafo mantiene già i dati a mezza precisione. Il beneficio concreto dipende però dal supporto shader-f16 del dispositivo e dal peso di queste operazioni nel workload.
Confine operativo
WebGPU porta llama.cpp in ambienti browser e runtime multipiattaforma, ma disponibilità e prestazioni cambiano con browser, driver e adattatore GPU. La presenza del codice non garantisce che ogni dispositivo esponga FP16 né che un modello usi effettivamente queste primitive.
Condizioni e limiti
La release non include misure di latenza, memoria o throughput. Il cambiamento è circoscritto a fill e set_rows, quindi non va presentato come accelerazione generale di WebGPU. Va inoltre trattato come prerelease finché non entra in una build stabile verificata.
Checklist per una prova controllata
- Fissare la build b11382 e registrare commit e binario.
- Verificare che il browser o runtime esponga shader-f16.
- Registrare GPU, driver, browser e versione WebGPU.
- Eseguire un test funzionale che richiami fill e set_rows su tensori FP16.
- Confrontare output e tolleranze con il percorso FP32.
- Misurare memoria, tempo delle primitive e throughput end-to-end separatamente.
- Ripetere il test su almeno un secondo adattatore GPU.
- Non generalizzare il risultato a modelli che non usano queste operazioni.