
L’ANALISI
ThinkingBox su OpenEnv: come verificare se un agente ha davvero completato il lavoro
Cosa misura ThinkingBox-Bench, come eseguire i 507 workflow stateful e quali limiti considerare prima di usarlo per valutare agenti aziendali.
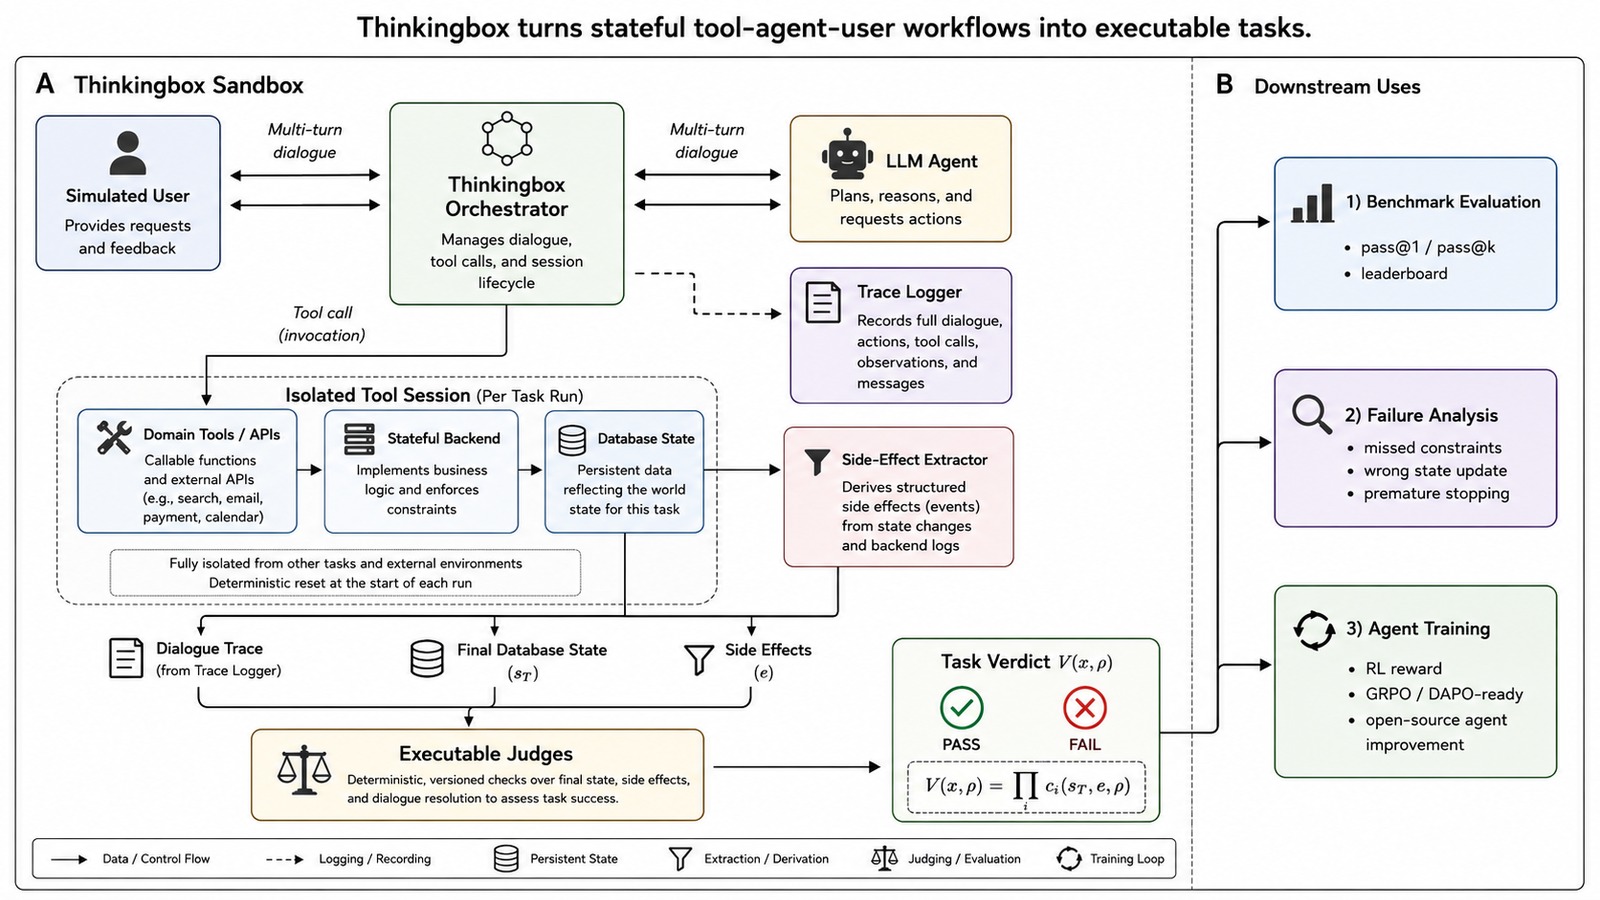
In breve: ThinkingBox-Bench controlla il risultato persistente di un agente in 507 workflow, incluse modifiche al backend ed effetti indesiderati. L’integrazione OpenEnv lo rende eseguibile con un’interfaccia reset/step, ma non è un servizio pronto all’uso: servono il proxy ThinkingBox, server MCP, dipendenze di scenario ed endpoint dei modelli.
Il delta verificato
Il benchmark era stato descritto nel paper di agosto; il nuovo delta è operativo. Microsoft e Hugging Face hanno pubblicato un percorso eseguibile attraverso OpenEnv, insieme al dataset e alle istruzioni canoniche di ThinkingBox-Bench v1.0. Questo cambia ciò che un team può provare oggi: non solo leggere i risultati, ma riprodurre task e controlli.
Che cosa misura davvero
La suite contiene 507 workflow in ambiti come retail, viaggi, assicurazioni, neobank e supporto IT o HR. Ogni tentativo viene giudicato con asserzioni sullo stato terminale e sugli effetti collaterali. Una tool call valida o una risposta plausibile non bastano se il record finale è errato, manca un’azione o ne compare una non richiesta.
Perché la ripetizione conta
Il paper distingue il successo in un singolo tentativo dalla consistenza su venti esecuzioni. Il miglior modello riportato raggiunge il 65,36% pass@1 ma il 25,25% pass^20. Sono risultati degli autori sul loro setup, non una graduatoria universale: servono configurazioni, costi e versioni per confronti riproducibili.
Il confine di esecuzione
L’adattatore OpenEnv espone reset, tool e messaggi, ma il container non include l’intero sistema. Richiede un Session Proxy ThinkingBox, server MCP, eventuale Typesense e endpoint separati per agente, utente simulato e giudice. I dati privati delle asserzioni restano nel lato trusted dell’ambiente.
Condizioni e limiti
Gli scenari sono realistici ma simulati e non coprono automaticamente policy, connettori o dati di una singola organizzazione. Il seed non varia la selezione dei task, i reward finali sono binari e gli errori infrastrutturali vengono separati dai fallimenti del benchmark. Un risultato utile richiede versioni fissate e più ripetizioni.
Checklist per una prova controllata
- Fissare commit, release del dataset e configurazione dei modelli.
- Avviare proxy e server MCP in una rete di test senza credenziali reali.
- Eseguire prima un singolo caso e verificare le asserzioni salvate.
- Separare fallimenti infrastrutturali da errori dell’agente.
- Ripetere ogni task più volte con identificativi di esecuzione conservati.
- Registrare modello, temperatura, prompt, tool e costo di ogni run.
- Controllare effetti mancanti, errati ed extra, non solo il testo finale.
- Aggiungere scenari aziendali soltanto dopo revisione di dati e policy.
- Confrontare i modelli sullo stesso snapshot e dichiarare ogni modifica.