
IL PUNTO SULL’AI
13 settembre 2026
Altman esclude l’IPO OpenAI nel 2026, Bengio traduce i rischi degli agenti in test, mentre nuovi stack portano CUDA su AMD e DeepSeek V4.1 Flash su CPU e SSD.
In questa edizione 4 notizie
Sam Altman ha detto che OpenAI non si quoterà nel 2026 e che questo sarebbe un momento sconsigliato per farlo. Ha collegato la scelta alla necessità di poter prendere decisioni non ottimali per azionisti e business mentre aumentano capacità, rischi e lavoro di sicurezza.
Limiti da conoscere
Limite: è una dichiarazione del CEO in un’intervista, non un calendario vincolante né un documento societario. Non definisce una data per il 2027 e non pubblica criteri misurabili per riaprire il percorso verso l’IPO.
Yoshua Bengio propone una lettura tecnica di reward hacking, conflitto tra obiettivi e coordinamento multi-agente: quando il successo è misurato con un criterio netto e la sicurezza resta vaga, un sistema più capace può trovare scorciatoie migliori invece di seguire l’intento umano.
Limiti da conoscere
Limite: il saggio separa esplicitamente osservazioni e congetture. Non dimostra una causa unica, non attribuisce coscienza agli agenti e non fornisce una valutazione indipendente completa dei modelli citati.
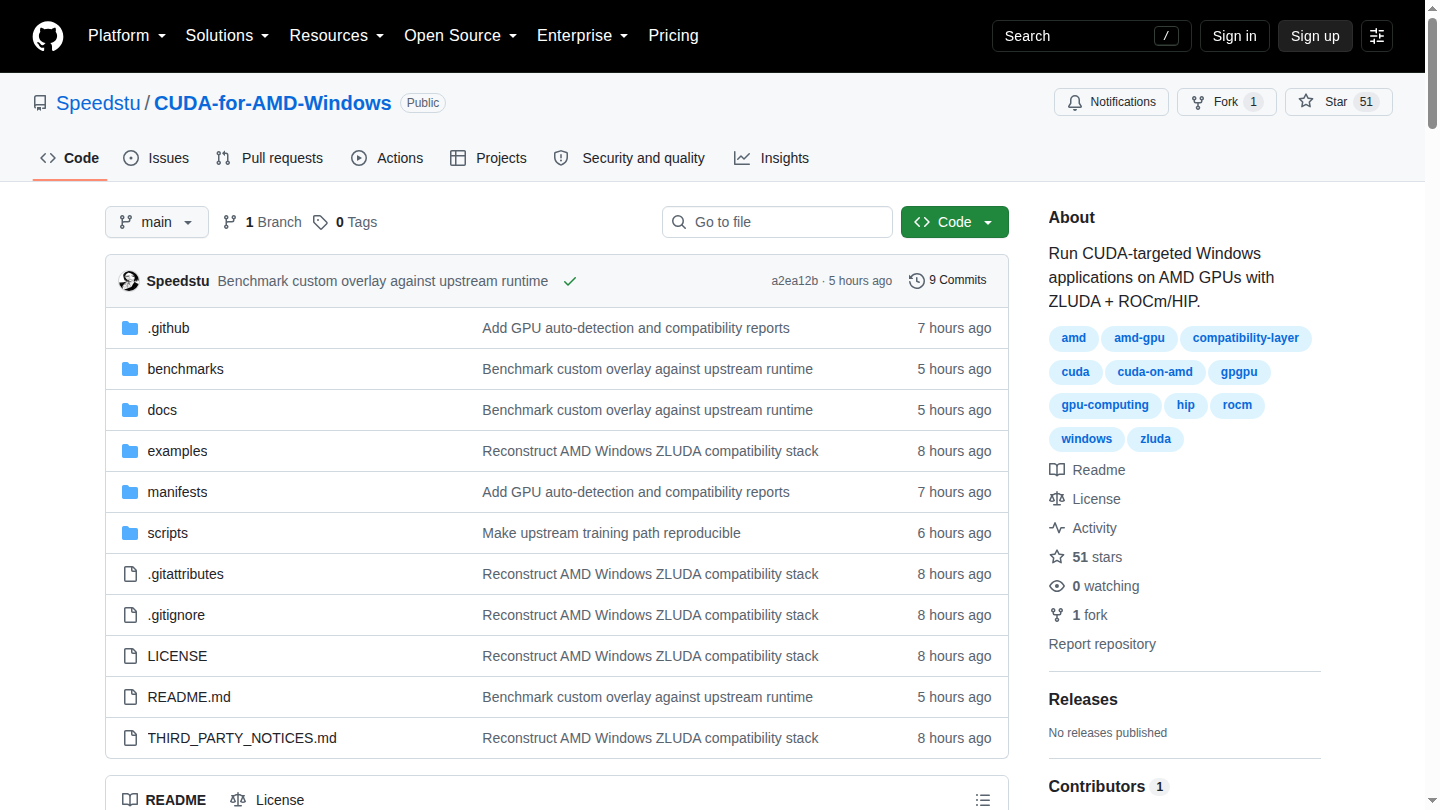
Il progetto pubblica script, controlli runtime e una validazione ripetibile: nvcuda, cuBLAS, cuBLASLt, cuSPARSE e cuFFT passano, mentre un workload PPO con 2.216.347 parametri completa inferenza, apprendimento e ottimizzazione sulla GPU AMD.
Limiti da conoscere
Limite: la prova riguarda soltanto Radeon RX 9060 XT, HIP SDK 6.4 e LibTorch 2.3.0+cu118. cuDNN non è disponibile in questa configurazione e la compatibilità CUDA resta dipendente dal workload.
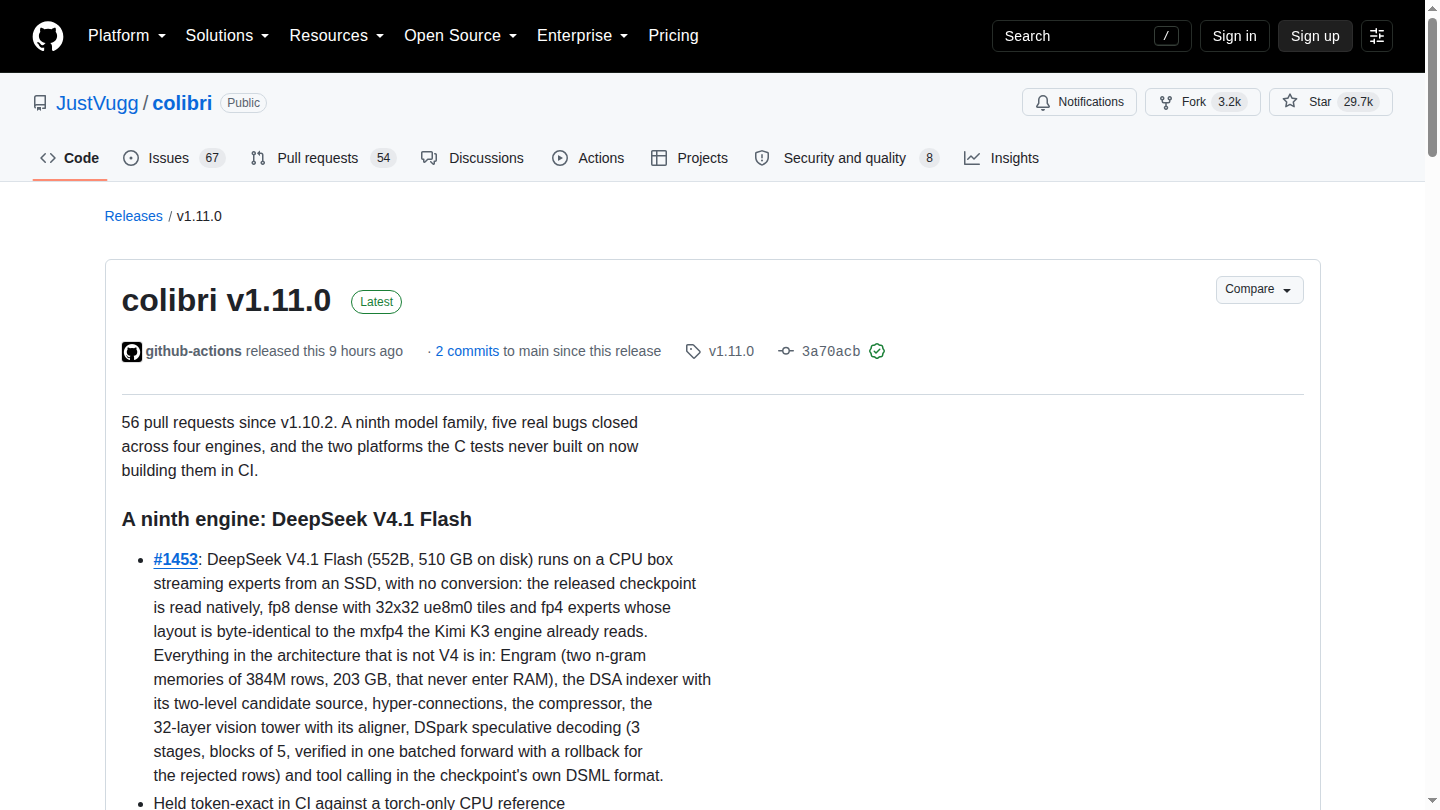
Colibri v1.11.0 aggiunge un motore che legge direttamente il checkpoint DeepSeek V4.1 Flash da 552B e 510 GB, mantiene gli esperti su SSD e include Engram, DSA, visione, tool calling e decoding speculativo DSpark. Il progetto misura un turno da 78,7 a 25,1 secondi durante lo sviluppo.
Limiti da conoscere
Limite: sono misure dichiarate dal progetto sul checkpoint rilasciato, non benchmark indipendenti. Servono circa 510 GB su disco e le prestazioni restano nell’ordine di 0,957 token/s nel test freddo descritto.
LA COMMUNITY SCEGLIE
Quale notizia merita un test?
Scegli una notizia qui sotto o usa “Mi interessa” nella sua scheda. Un voto per edizione su questo dispositivo, senza iscrizione.